ランダムフォレスト ― 予測は失敗、「特徴量重要度」の落とし穴を学ぶ
「機械学習を使えば、決算の良し悪しから株価の反応を予測できるはず」。そう期待したくなります。本記事は ランダムフォレスト という別の手法で、もう一度「決算 10 指標からCAR(決算前後の超過リターン)の上下を当てられるか」を検証します。
結論を先に書くと 当てられません。しかもその過程で、「特徴量重要度」という指標そのものの落とし穴 が見えてきます。
ランダムフォレストで「上 / 下」を当てられるか試す
ランダムフォレストは、多数の決定木の多数決で予測する定番の機械学習手法です。記事 3-1/3-2 と同じ 決算 10 指標(YoY 各種・利益率・配当成長・セグメント情報)を入力に、CAR[-1,+5] の符号(上 / 下)を分類 させます。
予測精度で「当たらないこと」を確認
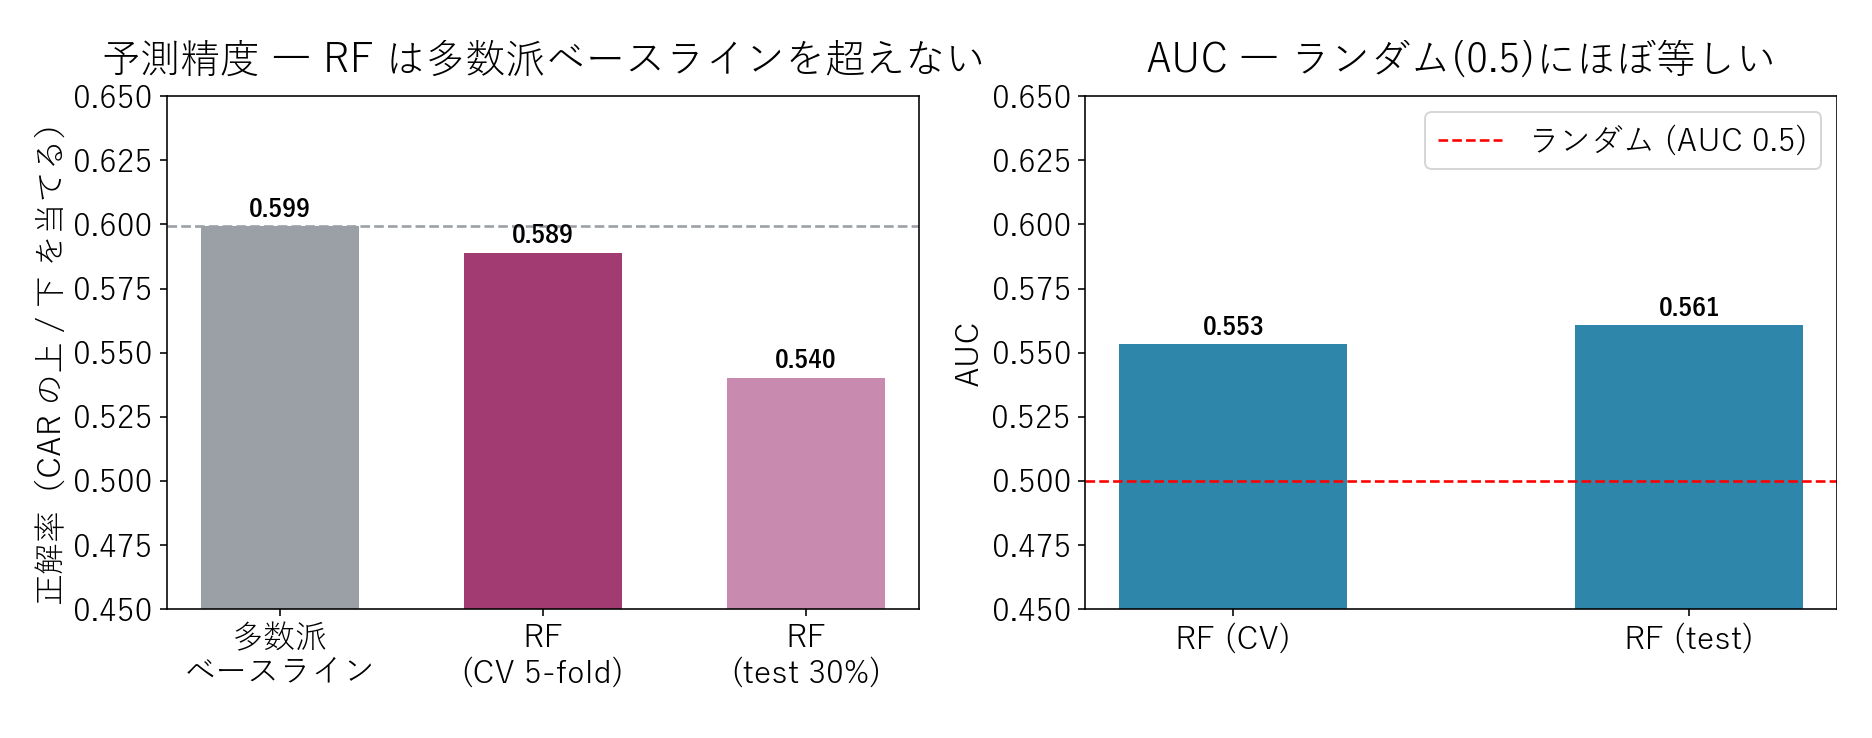
- 交差検証の正解率 0.589 < ベースライン 0.599 ― ランダムフォレストは「常に下」と言うだけのルールにすら勝てません
- ホールドアウト(test)では 0.540 とさらに低下。AUC(1 に近いほど精度が高く 0.5 はデタラメ)も 0.55 前後 で、ほぼ当てずっぽう
- 別手法でも予測は失敗 ― 3-2 の K-NN(相関 r ≈ 0)と独立に、「数値特徴量だけで市場反応は当てられない」が裏付けられました
特徴量重要度で「効く指標の罠」を観測
「当たらない」のは分かった。では どの決算指標が効いているのか? ここに落とし穴があります。重要度には測り方が 2 つあり、①分岐に使われた回数を数える方式(impurity) と ②その指標の値をわざとシャッフルして精度がどれだけ落ちるか試す方式(permutation) で、結果が食い違うのです。
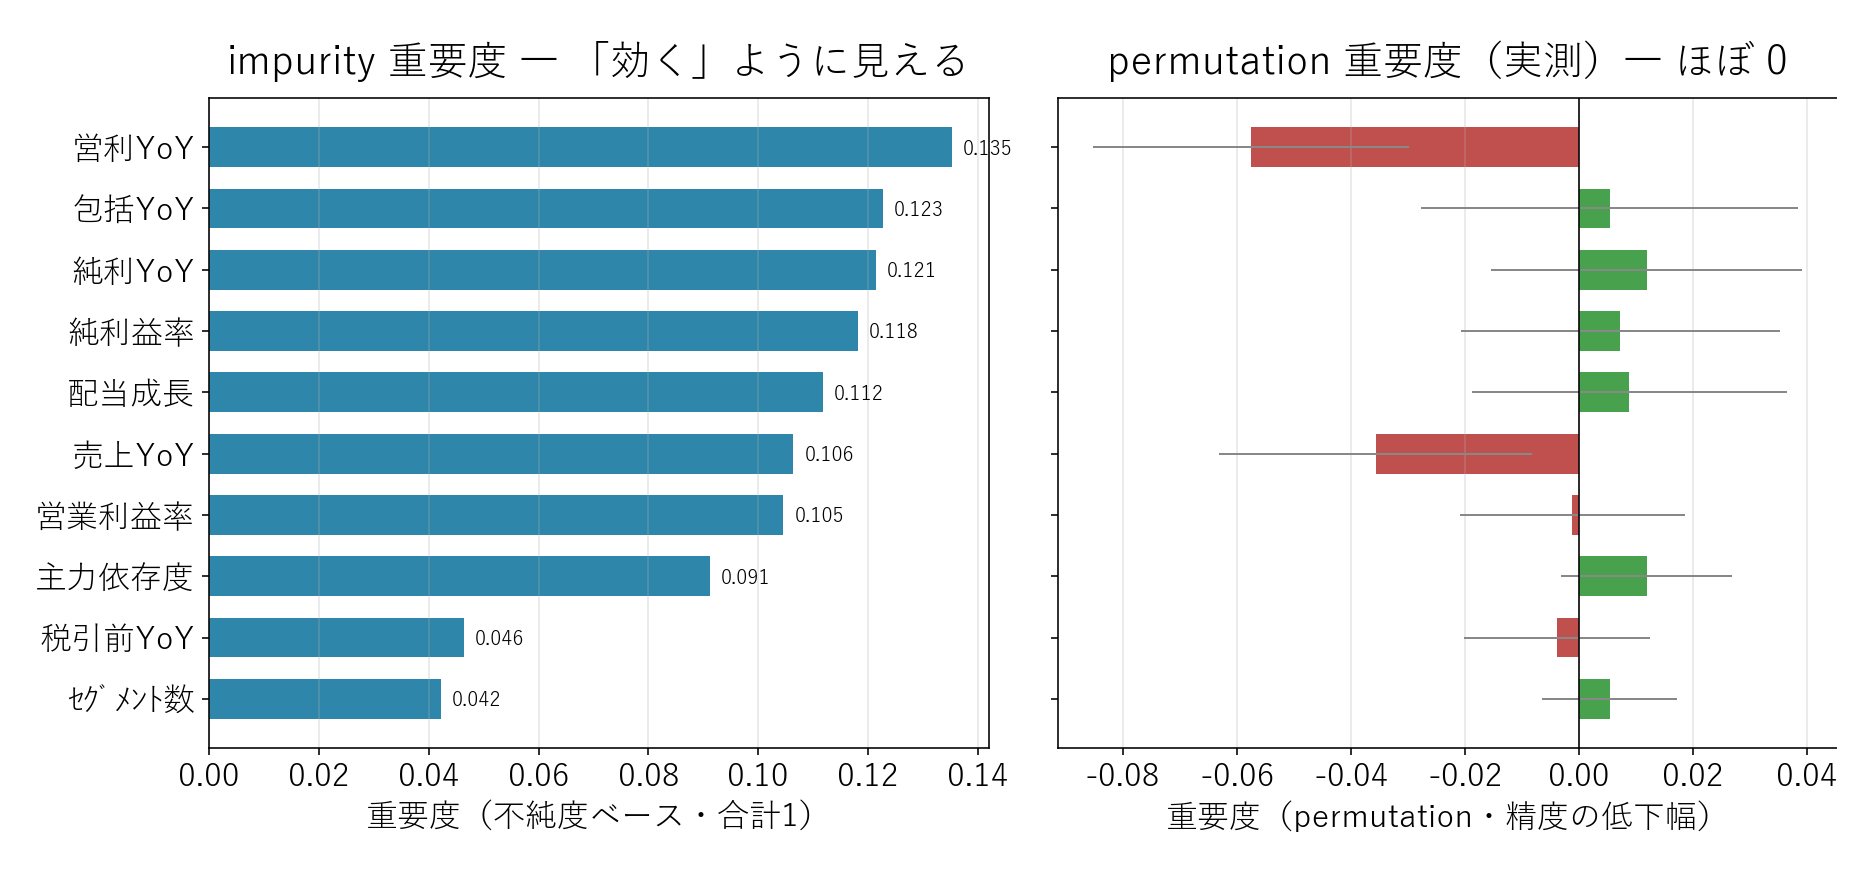
- 左(①impurity) では、営利 YoY・包括 YoY・純利 YoY が上位に並び、いかにも「効いている」ように見えます
- しかし 右(②permutation=実際に試す方式) で測ると どれもほぼ 0。それどころか営利 YoY・売上 YoY は マイナス(シャッフルした方が精度が上がる=ただのノイズだった)
- ①は「分岐に使われた回数」を数えるだけなので、値が細かく散らばる指標を過大評価 します。"効いて見える" 指標も、実際には効いていない ― 重要度は ②permutation で確かめるのが鉄則
ENEOS ― モデルの予測はコイン投げ
この分析の中核ENEOSについて、ランダムフォレストが出した上昇確率は 0.53(ほぼ五分五分)。一方、実際のCAR[-1,+5] は −4.68%(下落) でした。
つまりモデルは「分からない」と言ったに等しく、結果も外しています。ENEOSを動かしたのは決算の数値ではなく、記事 2-7(CAR)で見た 業績予想修正への市場反応 や、のれん減損・在庫影響といった 数値外の構造要因 でした。数字のパターンからは、やはり読めません。
まとめ
- ランダムフォレストでもCARの方向は当てられない(CV正解率 0.589 < ベースライン 0.599、AUC 0.55)。K-NN(3-2)と独立に同じ結論
- impurity 重要度は「効く」ように見せるが、permutation で測るとほぼ 0 ― 重要度指標そのものの過大評価バイアスという発見
- 数値だけで市場反応は予測できない。機械学習は 予測の魔法ではなく、整理・発見の道具(この分析を貫く結論)
- ENEOSも予測はコイン投げ。株価を動かすのは数値外の材料(構造要因・IR・市場の解釈)
Python コード
本記事のチャート画像・データ取得・成形スクリプトは、すべて GitHub に公開しています。ランダムフォレストの実装(交差検証・ホールドアウト・permutation importance・impurity との比較)は、リポジトリの README にまとめています。データは提供元の利用規約により再配布できませんが、データを各自取得すれば、この記事と同じものが再現できます。